
Урок 14. Метод k-ближайших соседей (KNN): многоклассовая классификация и регрессия
На этом занятии мы продолжаем изучение задач классификации и переходим от бинарного разделения к многоклассовой классификации. Мы подробно познакомимся с одним из самых интуитивно понятных, эффективных и быстрых алгоритмов машинного обучения — методом k-ближайших соседей (k-Nearest Neighbors, KNN). Мы разберем, почему его называют «ленивым» алгоритмом (Lazy Learning), почему для него критически важна стандартизация данных, как использовать классификацию по радиусу и как с помощью этого же подхода решать задачи регрессии.
1. Интуиция метода k-ближайших соседей (KNN)
В отличие от многих алгоритмов, которые сводят многоклассовую классификацию к серии бинарных сравнений (стратегии One-vs-Rest или One-vs-One), алгоритм KNN (k-Nearest Neighbors) изначально и естественно работает с любым количеством классов — тремя, четырьмя, сотней и более.
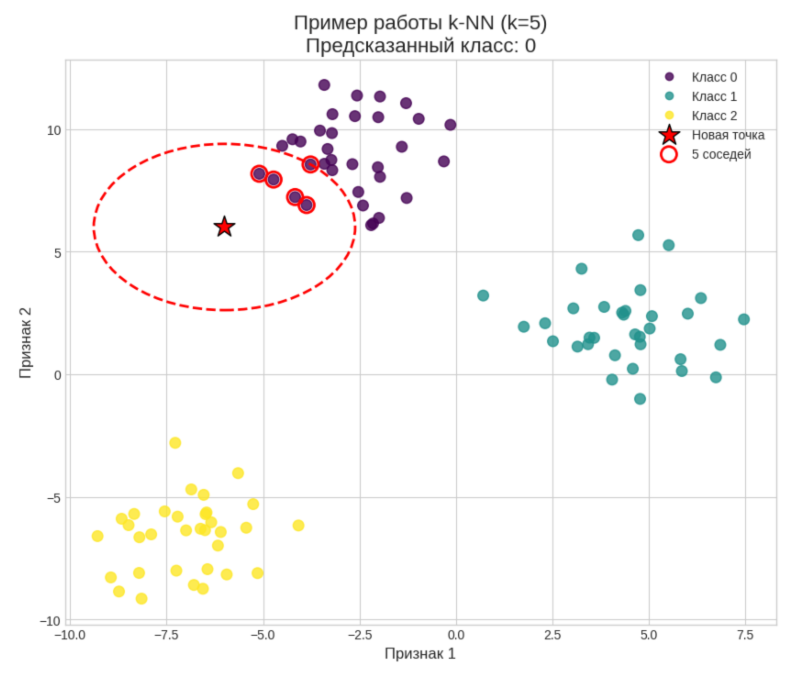
В основе алгоритма лежит житейская мудрость: «Скажи мне, кто твои друзья, и я скажу, кто ты». В машинном обучении это формулируется так: класс нового объекта определяется классом большинства его ближайших соседей в признаковом пространстве.
Важно не путать: в машинном обучении есть два популярных алгоритма с буквой «k»:
- k-NN (k-Nearest Neighbors) — обучение с учителем (Supervised Learning) для задач классификации и регрессии. Требует наличия заранее размеченных обучающих данных.
- k-Means — обучение без учителя (Unsupervised Learning) для кластеризации данных без целевых меток.
Каждый объект датасета описывается вектором из \(n\) числовых характеристик и представляет собой точку в \(n\)-мерном пространстве признаков. Когда в систему поступает новый объект с неизвестным классом, алгоритм выполняет три простых шага:
- Находит расстояние от нового объекта до всех существующих объектов обучающей выборки.
- Отбирает \(k\) объектов с наименьшим расстоянием (ближайших соседей).
- Проводит мажоритарное голосование: подсчитывает количество представителей каждого класса среди отобранных \(k\) соседей и присваивает объекту класс победителя.
2. Концепция «ленивого обучения» (Lazy Learning) и метрики расстояния
KNN называют «ленивым» алгоритмом (Lazy Learning). В классических моделях (например, линейной или логистической регрессии) вызов метода fit() запускает тяжелый процесс оптимизации весов (градиентный спуск), после чего обучающие данные можно удалить из памяти. В KNN ситуация обратная:
- На этапе
fit()реального обучения не происходит. Модель просто сохраняет обучающую выборку в оперативной памяти и организует ее в специальные древовидные структуры (например, KD-деревья или Ball-деревья) для ускорения последующего поиска. - Все вычисления (поиск соседей, расчет расстояний и голосование) выполняются динамически непосредственно в момент вызова метода
predict().
Как рассчитывается расстояние между объектами?
По умолчанию в большинстве реализаций используется классическое Евклидово расстояние в \(n\)-мерном пространстве. Расстояние между объектом \(x = (x_1, x_2, \dots, x_n)\) и объектом \(y = (y_1, y_2, \dots, y_n)\) вычисляется по формуле:
$$ d(x, y) = \sqrt{\sum_{i=1}^{n} (x_i – y_i)^2} $$
3. Гиперпараметры KNN: выбор k, классификация по радиусу и веса
Для настройки производительности и точности алгоритма используются три ключевых гиперпараметра:
1. Количество соседей (\(k\))
По умолчанию в библиотеке Scikit-Learn принимается \(k = 5\). При бинарной классификации число \(k\) практически всегда выбирают нечетным (\(3, 5, 7\)), чтобы избежать патовой ситуации равного разделения голосов (\(50\% / 50\%\)). Слишком малое \(k\) делает модель уязвимой к случайным выбросам и шуму (переобучение), а чрезмерно большое — стирает локальные границы между классами (недообучение).
2. Классификация по радиусу (RadiusNeighborsClassifier)
Если данные в признаковом пространстве распределены неравномерно (есть зоны высокой плотности и разреженные области), фиксированное число соседей \(k\) может заставлять модель «захватывать» точки, находящиеся далеко от исследуемого объекта. В таких случаях используется модификация — классификация по радиусу:
- Вместо фиксированного числа \(k\) задается радиус сферы \(r\).
- В голосовании участвуют только те точки, которые попали внутрь сферы радиуса \(r\) вокруг целевого объекта. Число соседей становится переменным.
3. Взвешивание голосов по расстоянию (weights=’distance’)
По умолчанию все отобранные соседи имеют равное право голоса (weights='uniform'). Однако логично, что сосед, расположенный вплотную к объекту, должен иметь больший вес, чем сосед на границе радиуса. Параметр weights='distance' назначает вес голоса каждого соседа обратно пропорционально расстоянию до него:
$$ w_i = \frac{1}{d(x, x_i)} $$
Это исключает проблемы ничейных исходов и значительно повышает устойчивость модели на реальных задачах.
4. Критическая важность стандартизации признаков (StandardScaler)
Золотое правило метрических алгоритмов: Если признаки измерены в разных масштабах, признак с большими числовыми значениями будет полностью доминировать в расчете расстояний, превращая остальные признаки в статистический шум.
Например, если в задаче классификации один признак измеряется в метрах (значения от \(1\) до \(10\)), а второй — в рублях (значения от \(100\,000\) до \(1\,000\,000\)), разница по второму признаку напрочь заглушит первый. Поэтому перед обучением KNN обязательно требуется масштабирование (приведение признаков к нулевому среднему и единичному стандартному отклонению с помощью StandardScaler):
$$ z = \frac{x – \mu}{\sigma} $$
Если для нового объекта предсказание строится на немасштабированных признаках, результат классификации будет заведомо неверным. Чтобы избежать ошибок предобработки, в продакшене масштабирование и модель объединяют в Pipeline.
5. Практическая реализация многоклассовой классификации в Scikit-Learn
Решим задачу трехклассовой классификации на классическом датасете Ирисов Фишера (все 3 класса: Setosa, Versicolor, Virginica по 4 признакам):
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import classification_report, accuracy_score

# 1. Загрузка данных (все 3 класса)
iris = load_iris()
X = iris.data
y = iris.target

# 2. Масштабирование признаков
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)

# 3. Стратифицированное разбиение на обучающую и тестовую выборки (70/30)
X_train, X_test, y_train, y_test = train_test_split(
    X_scaled, y, test_size=0.3, random_state=0, stratify=y
)

# 4. Инициализация и «обучение» модели KNN
knn = KNeighborsClassifier(n_neighbors=5, weights='distance')
knn.fit(X_train, y_train)

# 5. Предсказание на тестовых данных
y_pred = knn.predict(X_test)

# 6. Оценка качества
print(f"Общая точность (Accuracy): {accuracy_score(y_test, y_pred):.2f}\n")
print("Classification Report:")
print(classification_report(y_test, y_pred, target_names=iris.target_names))
Результат выполнения: модель достигает общей точности 0.98, демонстрируя практически безошибочное разделение трех классов на тестовых данных при минимальном времени исполнения.
6. Применение метода соседей для задач регрессии (KNeighborsRegressor)
Один из самых интересных и практичных аспектов метода ближайших соседей — возможность его мгновенной адаптации для решения задач регрессии с непрерывной целевой переменной.
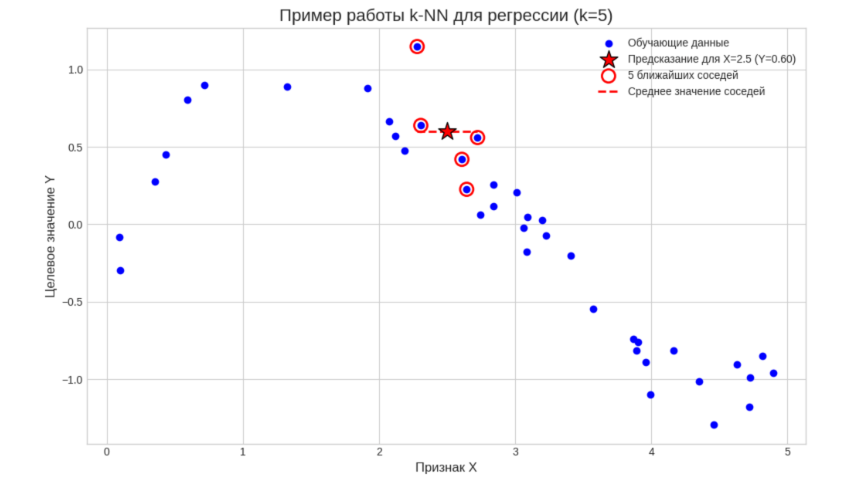
Бизнес-кейс (Оценка стоимости аренды квартиры): Представим, что требуется оценить стоимость аренды новой квартиры. Вместо сложного подбора нелинейных уравнений или полиномов высоких степеней мы можем:
- Найти в признаковом пространстве \(k\) квартир, максимально похожих на оцениваемую (по площади, количеству комнат, удаленности от метро, этажу и т.д.).
- Взять фактическую стоимость аренды этих \(k\) квартир и вычислить их среднее значение (или взвешенное среднее).
В Scikit-Learn этот функционал реализован в классе KNeighborsRegressor. Предсказанное значение непрерывной величины \(\hat{y}\) рассчитывается как простое или взвешенное среднее меток соседей:
$$ \hat{y} = \frac{1}{k} \sum_{i=1}^{k} y_i \quad \text{или} \quad \hat{y} = \frac{\sum_{i=1}^{k} w_i y_i}{\sum_{i=1}^{k} w_i} $$
from sklearn.neighbors import KNeighborsRegressor

# Пример создания регрессора на k-соседях
knn_reg = KNeighborsRegressor(n_neighbors=5, weights='distance')
knn_reg.fit(X_train, y_train_continuous)
predictions = knn_reg.predict(X_test)
KNN-регрессор работает чрезвычайно быстро и часто обеспечивает качество, сопоставимое с полиномиальной регрессией (по метрикам MSE и \(R^2\)), но без необходимости вручную конструировать степени признаков.
План занятия
-
Переход к многоклассовой классификации и логика KNN
- Ограничения бинарных моделей и стратегии многоклассового разделения.
- Философия алгоритма: классификация объекта по принадлежности окружающих точек.
- Различие алгоритмов со сходными названиями: k-NN (классификация) vs k-Means (кластеризация).
- Обучение с учителем: необходимость размеченного пространства признаков.
-
Концепция «ленивого обучения» (Lazy Learning)
- Что на самом деле делает метод
fit()в KNN (индексация и оптимизация в памяти). - Почему этап
predict()берет на себя основные вычислительные затраты. - Метрики расстояния: формула Евклидова расстояния в \(n\)-мерном признаковом пространстве.
- Что на самом деле делает метод
-
Гиперпараметры классификаторов на основе соседей
- Выбор числа соседей \(k\): баланс между переобучением (шум) и недообучением.
- Проблема четных значений \(k\) и ничейных исходов голосования.
- Классификация по радиусу:
RadiusNeighborsClassifierи работа с неравномерной плотностью. - Взвешивание соседей по обратному расстоянию: параметр
weights='distance'.
-
Роль масштабирования признаков в метрических моделях
- Почему признаки разного масштаба искажают евклидово расстояние.
- Стандартизация признаков с помощью
StandardScaler. - Предотвращение утечки данных и применение
Pipelineпри предсказании новых значений.
-
Практическая работа в Scikit-Learn и адаптация к регрессии
- Классификация 3 классов датасета Iris с помощью
KNeighborsClassifier. - Анализ отчета
classification_report(Precision, Recall, F1, Support). - Применение алгоритма к регрессионным задачам:
KNeighborsRegressor. - Оценка непрерывных величин через локальное усреднение соседей в сравнении с полиномиальной регрессией.
- Классификация 3 классов датасета Iris с помощью