
Урок 15. Метод опорных векторов (SVM): максимизация зазора, ядерный трюк и классификатор SVC
На этом занятии мы знакомимся с одним из самых мощных, элегантных и математически выверенных методов классического машинного обучения — методом опорных векторов (Support Vector Machine, SVM). Этот алгоритм демонстрирует выдающиеся результаты при решении сложнейших задач классификации и регрессии. В ситуациях, когда объем обучающей выборки ограничен, а глубокие нейронные сети склонны к переобучению и требуют огромных массивов данных, грамотно настроенный SVM зачастую не уступает, а превосходит нейросетевые архитектуры.
1. Ограничения линейного классификатора и ключевая идея SVM
Ранее мы рассматривали Перцептрон (Perceptron) и Логистическую регрессию. Линейный классификатор подбирает разделяющую прямую (или гиперплоскость), минимизируя ошибки. Однако, если данные линейно разделимы, существует бесконечное множество линий, способных разделить два класса:
Проблема перцептрона: Как только алгоритм находит хоть какую-нибудь прямую, безошибочно разделяющую точки двух классов, обучение останавливается. Линия может пройти вплотную к объектам одного из классов. При появлении новых тестовых данных малейшее отклонение приведет к ошибке классификации.
Метод опорных векторов решает эту проблему фундаментально. Вместо случайной разделяющей границы SVM находит оптимальную разделяющую гиперплоскость, которая обеспечивает наилучшую обобщающую способность модели.
2. Суперсила №1: Максимизация зазора (Margin Maximization)
Разделяющая гиперплоскость в \(n\)-мерном пространстве описывается уравнением:
$$ w^T x + b = 0 $$
SVM не просто ищет разделяющую плоскость, он стремится максимизировать зазор (Margin) — расстояние между гиперплоскостью и ближайшими к ней точками обучающей выборки с обеих сторон.
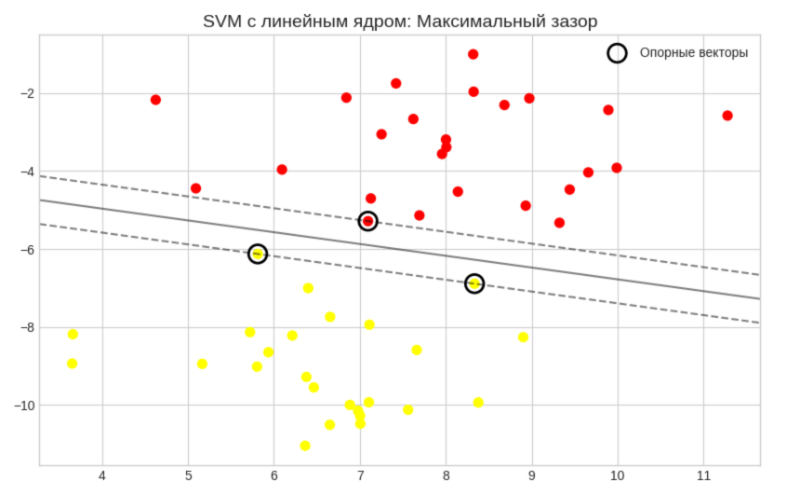
Параллельный сдвиг разделяющей плоскости в сторону каждого из классов формирует границы зазора:
- Положительная граница зазора: \(w^T x + b = 1\)
- Отрицательная граница зазора: \(w^T x + b = -1\)
Ширина зазора между этими плоскостями геометрически выражается формулой:
$$ \text{Margin} = \frac{2}{\|w\|} $$
Максимизация ширины зазора эквивалентна минимизации нормы вектора весов \(\|w\|\), что превращает поиск плоскости в строгую математическую задачу квадратичной оптимизации. Чем шире зазор, тем больше «запас прочности» модели при поступлении новых зашумленных данных.
3. Суперсила №2: Опорные векторы и компактность модели
Точки обучающей выборки, которые попадают точно на границы зазора (или внутрь него при мягком зазоре), называются опорными векторами (Support Vectors). Они буквально «подпирают» границы разделяющей полосы.
Уникальное свойство алгоритма SVM: Положение разделяющей гиперплоскости зависит исключительно от опорных векторов. Все остальные точки обучающей выборки можно удалить из памяти — граница решений от этого не изменится ни на миллиметр.
Благодаря этому обученная модель SVM чрезвычайно компактна: алгоритм сохраняет в памяти лишь координаты небольшого числа опорных векторов и их весовые коэффициенты, что гарантирует молниеносную скорость на этапе предсказания (predict).
4. Многоклассовая классификация: One-vs-Rest против One-vs-One
Математически SVM сформулирован как бинарный классификатор. Для перехода к многоклассовым задачам (например, датасету Ирисов с тремя классами) используются две основные стратегии:
- One-vs-Rest (OvR / One-vs-All): Для \(N\) классов обучается \(N\) моделей. Каждая модель учится отличать свой класс от всех остальных объединенных классов. Побеждает класс с максимальной уверенностью классификатора.
- One-vs-One (OvO): Обучается отдельный бинарный классификатор для каждой возможной пары классов. Число моделей рассчитывается как:
$$ K = \frac{N(N – 1)}{2} $$
Для 3 классов обучается 3 классификатора: Setosa vs Versicolor, Setosa vs Virginica и Versicolor vs Virginica. Итоговый класс выбирается путем мажоритарного голосования всех парных моделей.
В библиотеке scikit-learn класс SVC по умолчанию реализует более точную стратегию One-vs-One (OvO).
5. Суперсила №3: Линейная неразделимость и «Ядерный трюк» (Kernel Trick)
Что делать, если данные невозможно разделить гиперплоскостью? Классический пример: один класс концентрически окружен другим классом (кольца на плоскости).
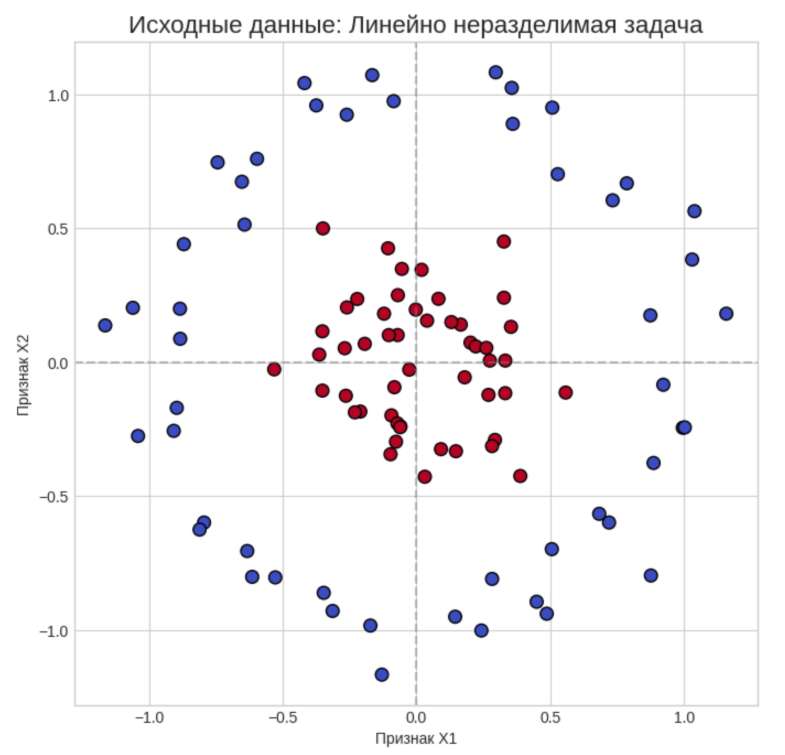
Интуиция перехода в высшую размерность
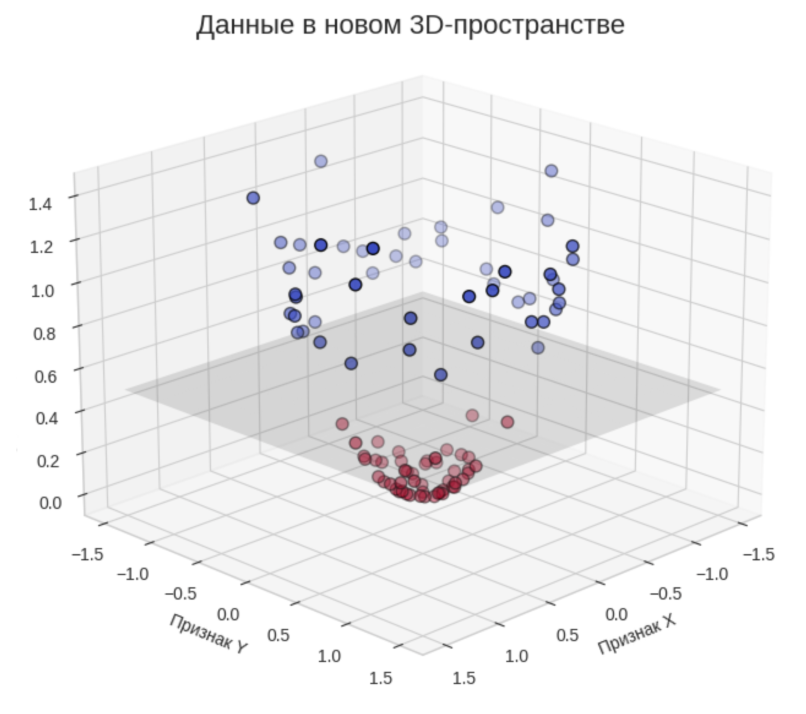
Представим, что мы смотрим на точки сверху в 2D. Если мы добавим искусственное третье измерение, пропорциональное квадрату расстояния от центра координат:
$$ z = x_1^2 + x_2^2 $$
Точки внутреннего круга останутся внизу (малое значение \(z\)), а точки внешнего круга «взлетят» наверх вдоль оси \(z\). В образовавшемся трехмерном пространстве оба класса легко и безупречно разделяются плоским горизонтальным срезом — двумерной плоскостью!
Магия ядер (Kernels)
Проблема в том, что явный пересчет признаков в пространства высокой размерности требует колоссальных вычислительных мощностей. Здесь и вступает в силу «Ядерный трюк» (Kernel Trick):
Суть Kernel Trick: Алгоритму SVM для оптимизации не нужны конкретные координаты точек в многомерном пространстве — ему необходимо знать только скалярные произведения между векторами. Функция ядра вычисляет это скалярное произведение напрямую через исходные координаты, моделируя переход в пространство бесконечной размерности «на лету» без дополнительных затрат памяти.
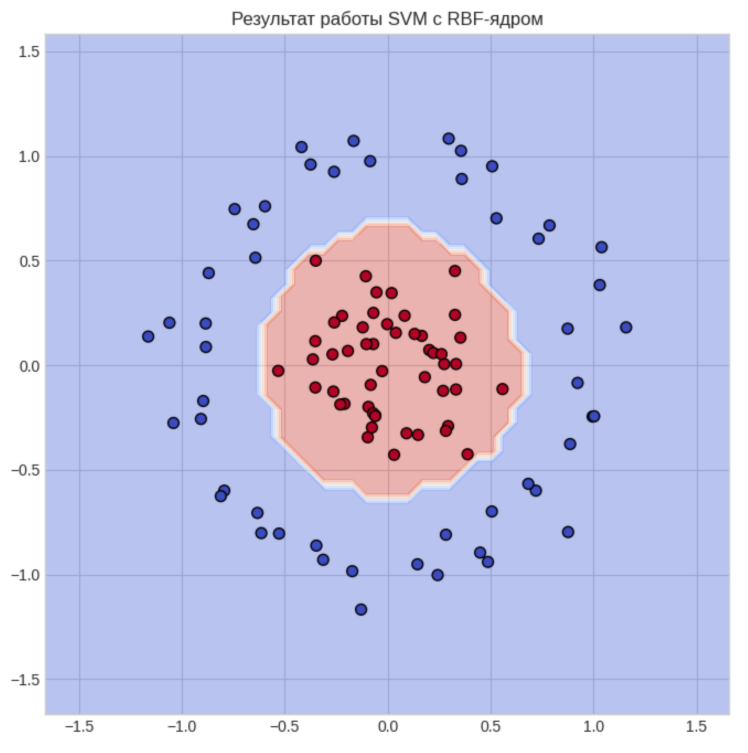
Основные ядра в Scikit-Learn:
linear— обычное скалярное произведение, строит линейные плоскости.poly— полиномиальное ядро, настраивается степеньюdegree.rbf(Radial Basis Function, Гауссово ядро) — самое мощное универсальное ядро по умолчанию:
$$ K(x, y) = \exp(-\gamma \cdot \|x – y\|^2) $$
6. Гиперпараметры классификатора SVC
Управление поведением модели sklearn.svm.SVC осуществляется через два ключевых гиперпараметра:
1. Параметр регуляризации \(C\)
Определяет компромисс между идеальной точностью на обучении и шириной зазора:
- Маленькое значение \(C\) (например, 0.01 или 0.1): мягкий зазор (Soft Margin). Модель допускает отдельные ошибки на обучающей выборке ради расширения зазора. Меньше риск переобучения, граница более плавная.
- Большое значение \(C\) (например, 100 или 1000): жесткий зазор (Hard Margin). Модель жестко штрафует за каждую ошибку, сжимая зазор. Высокий риск переобучения под шумы обучающих данных.
2. Параметр ядра \(\gamma\) (gamma)
Определяет «радиус влияния» отдельного обучающего примера при использовании ядер rbf и poly:
- Маленькая gamma: радиус влияния каждой точки велик. Граница решений строится плавно и полого.
- Большая gamma: радиус влияния мал. Модель формирует локальные воронки вокруг каждой точки. Граница получается извилистой, огибая каждый отдельный объект (высокий риск оверфиттинга).
7. Практическая реализация классификатора SVC в Scikit-Learn
Построим модель классификации трех видов Ирисов Фишера с применением RBF-ядра:
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC
from sklearn.metrics import classification_report, accuracy_score

# 1. Загрузка данных
iris = load_iris()
X, y = iris.data, iris.target

# 2. Масштабирование признаков (критически важно для SVM!)
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)

# 3. Стратифицированное разбиение выборки (70/30)
X_train, X_test, y_train, y_test = train_test_split(
    X_scaled, y, train_size=0.7, random_state=0, stratify=y
)

# 4. Инициализация и обучение модели SVM с RBF-ядром
svm_model = SVC(kernel='rbf', C=1.0, gamma='scale', decision_function_shape='ovo')
svm_model.fit(X_train, y_train)

# 5. Прогнозирование на тестовой выборке
y_pred = svm_model.predict(X_test)

# 6. Оценка качества
print(f"Accuracy модели: {accuracy_score(y_test, y_pred):.4f}\n")
print("Classification Report:")
print(classification_report(y_test, y_pred, target_names=iris.target_names))
Результат: модель показывает общую точность 0.98. Небольшая шероховатость между классами Versicolor и Virginica (F1-score 0.97) обусловлена не слабостью алгоритма, а физической природой самого датасета: при имеющихся четырех характеристиках лепестков и чашелистиков эти два вида ирисов в живой природе частично перекрывают друг друга по размерам.
8. Визуализация нелинейных границ решений
Посмотрим, как RBF-ядро очерчивает границы классов на плоскости чашелистиков и лепестков с помощью сеточного прогнозирования (meshgrid и contourf):
import numpy as np
import matplotlib.pyplot as plt
from sklearn import svm, datasets

iris = datasets.load_iris()
X = iris.data
y = iris.target

# Обучаем две модели на разных парах признаков
clf_sepal = svm.SVC(kernel='rbf', gamma=0.7, C=1.0).fit(X[:, :2], y)
clf_petal = svm.SVC(kernel='rbf', gamma=0.7, C=1.0).fit(X[:, 2:], y)

def make_meshgrid(x, y, h=0.02):
    x_min, x_max = x.min() - 1, x.max() + 1
    y_min, y_max = y.min() - 1, y.max() + 1
    return np.meshgrid(np.arange(x_min, x_max, h), np.arange(y_min, y_max, h))

def plot_contours(ax, clf, xx, yy, **params):
    Z = clf.predict(np.c_[xx.ravel(), yy.ravel()]).reshape(xx.shape)
    return ax.contourf(xx, yy, Z, **params)

fig, axes = plt.subplots(1, 2, figsize=(16, 7))

# График для чашелистиков (Sepal)
xx, yy = make_meshgrid(X[:, 0], X[:, 1])
plot_contours(axes[0], clf_sepal, xx, yy, cmap=plt.cm.coolwarm, alpha=0.5)
axes[0].scatter(X[:, 0], X[:, 1], c=y, cmap=plt.cm.coolwarm, s=40, edgecolors='k')
axes[0].set_title('Границы решений SVM (Sepal length vs width)')

# График для лепестков (Petal)
xx, yy = make_meshgrid(X[:, 2], X[:, 3])
plot_contours(axes[1], clf_petal, xx, yy, cmap=plt.cm.coolwarm, alpha=0.5)
axes[1].scatter(X[:, 2], X[:, 3], c=y, cmap=plt.cm.coolwarm, s=40, edgecolors='k')
axes[1].set_title('Границы решений SVM (Petal length vs width)')

plt.show()
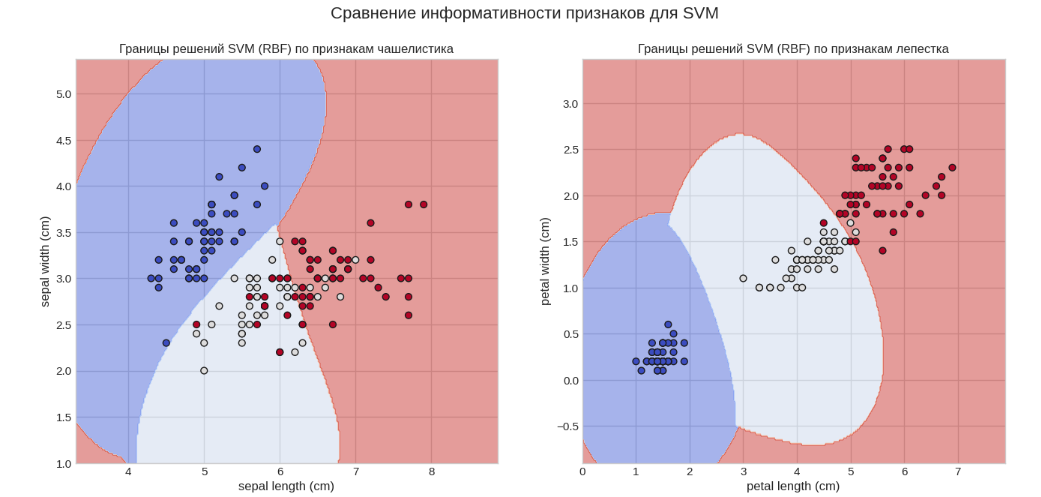
Графики демонстрируют гибкие, сложные замкнутые контуры, которые RBF-ядро выстраивает вокруг классов без необходимости ручной генерации полиномиальных признаков.
План занятия
-
Введение в Support Vector Machine (SVM)
- Место метода опорных векторов в машинном обучении.
- Почему SVM превосходит нейронные сети на ограниченных объемах данных.
- Недостатки линейного классификатора (перцептрона): случайность положения разделяющей линии.
- Концепция оптимальной гиперплоскости с максимальным запасом прочности.
-
Геометрия метода: Зазор (Margin) и Опорные векторы (Support Vectors)
- Уравнение гиперплоскости и параллельные границы зазора.
- Формула ширины разделяющей полосы \(\frac{2}{\|w\|}\).
- Опорные векторы: определение граничных точек обучающей выборки.
- Принцип компактности: независимость модели от точек вне зазора.
-
Стратегии многоклассовой классификации в SVM
- Ограничения бинарной формулировки алгоритма.
- Стратегия One-vs-Rest (OvR): \(N\) моделей для \(N\) классов.
- Стратегия One-vs-One (OvO): попарные дуэли и формула \(\frac{N(N-1)}{2}\).
- Реализация стратегии OvO в классе
sklearn.svm.SVC.
-
Нелинейная классификация и «Ядерный трюк» (Kernel Trick)
- Проблема линейно неразделимых данных (концентрические кольца).
- Интуиция перехода в высшие размерности на примере 3D-параболоида (\(z = x^2 + y^2\)).
- Математическая суть ядра: неявный расчет скалярного произведения.
- Сравнение ядер: линейное (
linear), полиномиальное (poly) и радиально-базисное (rbf).
-
Настройка гиперпараметров и практика в Scikit-Learn
- Параметр регуляризации \(C\): компромисс между шириной зазора и ошибками (Hard Margin vs Soft Margin).
- Параметр \(\gamma\) (gamma): радиус влияния точек и кривизна границ решения.
- Обязательность масштабирования данных с помощью
StandardScaler. - Обучение классификатора
SVCна датасете Iris и анализ отчетаclassification_report. - Построение и визуализация нелинейных контуров решений с помощью
np.meshgrid. - Обзор семейства алгоритмов:
SVC(классификация),SVR(регрессия),OneClassSVM(аномалии).