
Урок 17. Кластеризация DBSCAN: плотностной анализ, поиск шума и нелинейные кластеры
На прошлом занятии мы рассмотрели алгоритм K-Means, который делит данные на группы вокруг центральных точек-центроидов. Однако метод k-средних имеет фундаментальное ограничение: он способен находить только выпуклые сферические кластеры и крайне чувствителен к выбросам. На этом занятии мы изучаем альтернативный, продвинутый подход к кластеризации — DBSCAN (Density-Based Spatial Clustering of Applications with Noise). Этот алгоритм группирует данные на основе локальной плотности точек, не требует предварительного указания количества кластеров, способен выделять структуры абсолютно любой произвольной формы и обладает встроенным механизмом выявления шума и аномалий.
1. Идея плотностной кластеризации
В алгоритме DBSCAN понятие кластера формулируется интуитивно понятным для человека образом:
Определение кластера в DBSCAN: Кластер — это связная область с высокой локальной плотностью точек, отделенная от других кластеров разреженными пространствами с низкой плотностью объектов.
В отличие от K-Means, где алгоритм оптимизирует расстояние до глобального центра масс (центроида), DBSCAN исследует локальное окружение каждой конкретной точки, двигаясь от соседа к соседу, как цепная реакция.
2. Ключевые параметры и классификация точек
Работа алгоритма опирается всего на два фундаментальных гиперпараметра, имеющих ясный физический смысл:
- eps (\(\varepsilon\), эпсилон): радиус сферической окрестности вокруг исследуемой точки.
- min_samples: минимальное пороговое количество точек, которое должно находиться внутри сферы радиуса \(\varepsilon\) (включая саму точку), чтобы эта область считалась достаточно плотной.
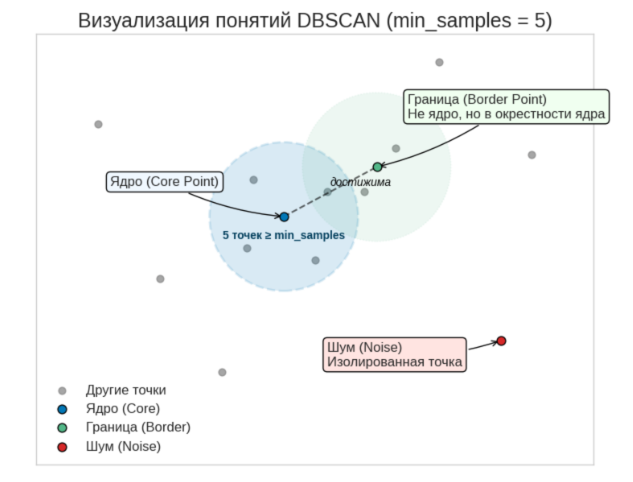
На основе подсчета соседей внутри сферы радиуса \(\varepsilon\) каждая точка датасета строго классифицируется на один из трех типов:
| Тип точки | Формальное условие | Роль в кластере |
|---|---|---|
| Ядро (Core point) |
Внутри \(\varepsilon\)-окрестности находится \(\ge \text{min\_samples}\) соседей. | Формирует и расширяет кластер, соединяя соседние плотные области. |
| Граница (Border point) |
Внутри \(\varepsilon\)-окрестности \(< \text{min\_samples}\), но точка лежит в окрестности какого-либо ядра. | Входит в состав кластера как его внешняя оболочка, но сама не способна присоединять новые точки. |
| Шум / Выброс (Noise point) |
Не является ядром и не находится в окрестности ни одной точки-ядра. | Изолированная точка. Не включается ни в один кластер и помечается меткой -1. |
3. Пошаговый механизм роста кластеров
Алгоритм последовательно просматривает пространство признаков по следующим шагам:
- Выбирается произвольная еще не посещенная точка выборки \(x\), и вычисляется количество ее соседей в пределах радиуса \(\varepsilon\).
- Если число соседей меньше
min_samples, точка временно помечается как шум (впоследствии она может стать границей, если попадет в окрестность другого ядра). - Если число соседей \(\ge \text{min\_samples}\), точка признается ядром и инициирует создание нового кластера.
- Все соседи точки-ядра добавляются в текущий кластер. Если среди них также оказываются точки-ядра, их соседи рекурсивно включаются в этот же кластер. Процесс роста продолжается лавинообразно до тех пор, пока плотная цепочка не оборвется.
- После стабилизации кластера алгоритм переходит к поиску следующего неразмеченного ядра.
- Все точки, так и не присоединившиеся ни к одной плотной группе, окончательно маркируются как шум.
4. Сравнение DBSCAN и K-Means: сильные и слабые стороны
| Критерий | K-Means | DBSCAN |
|---|---|---|
| Количество кластеров | Задается жестко пользователем вручную (гиперпараметр \(k\)). | Определяется автоматически по структуре плотности. |
| Форма кластеров | Только выпуклые сферические области одинакового радиуса. | Произвольная нелинейная форма (кольца, спирали, серпы). |
| Устойчивость к выбросам | Очень слабая: выбросы искажают центроиды и насильно включаются в кластеры. | Высокая: встроенный механизм изоляции выбросов в категорию шума. |
| Скорость на больших данных | Высокая линейная скорость \(O(N)\). Легко масштабируется. | Вычислительно тяжелее: \(O(N^2)\) в худшем случае без пространственных деревьев. |
5. DBSCAN как метод поиска аномалий (Anomaly Detection)
Благодаря тому, что DBSCAN не пытается распределить абсолютно все данные по группам, он стал одним из стандартных алгоритмов выявления аномалий и очистки данных:
Пример (Банковский антифрод): Большинство обычных платежей клиентов формируют плотные скопления по суммам, времени суток и категориям расходов. Нетипичные транзакции (огромная сумма посреди ночи из редкой локации) окажутся на значительном удалении от плотных ядер. DBSCAN автоматически присвоит им метку
-1, отправив операцию на ручную проверку службой безопасности или блокировку карты.
6. Практическая реализация в Scikit-Learn: кластеризация «двух лун»
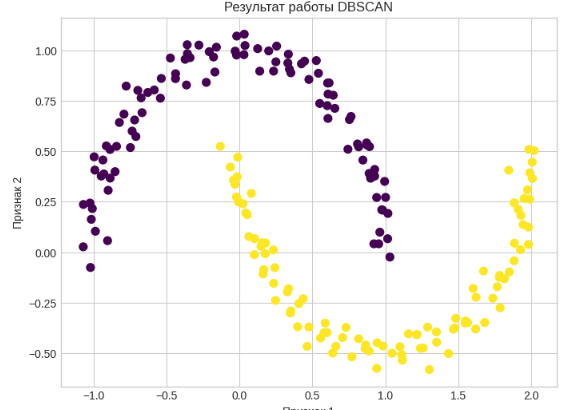
Для демонстрации силы алгоритма используем нелинейный синтетический датасет make_moons, представляющий собой два переплетенных полумесяца. Метод K-Means разделил бы эти данные пополам прямой линией, разрушив структуру. DBSCAN справляется идеально:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_moons
from sklearn.cluster import DBSCAN

# 1. Генерация нелинейных данных сложной формы
X, y = make_moons(n_samples=200, noise=0.05, random_state=0)

# 2. Инициализация и обучение DBSCAN
# eps - радиус окрестности, min_samples - порог плотности
db = DBSCAN(eps=0.3, min_samples=5)
db.fit(X)

# 3. Извлечение меток кластеров (-1 означает шум)
labels = db.labels_

# Подсчет количества найденных кластеров (исключая шум)
n_clusters_ = len(set(labels)) - (1 if -1 in labels else 0)
n_noise_ = list(labels).count(-1)

print(f"Количество найденных кластеров: {n_clusters_}")
print(f"Количество точек шума: {n_noise_}")

# 4. Визуализация результатов
plt.figure(figsize=(8, 6))

# Отрисовка шума черным цветом (если есть)
if n_noise_ > 0:
    plt.scatter(X[labels == -1, 0], X[labels == -1, 1],
                c='black', s=20, label='Шум (выбросы)')

# Отрисовка кластеров
plt.scatter(X[labels != -1, 0], X[labels != -1, 1],
            c=labels[labels != -1], cmap='viridis', s=50, edgecolors='k')

plt.title(f'Результат DBSCAN: {n_clusters_} кластера(ов), шума: {n_noise_}')
plt.xlabel("Признак 1")
plt.ylabel("Признак 2")
plt.grid(True)
plt.show()
Особенности работы с параметрами в Scikit-Learn:
- Атрибут
labels_: возвращает массив меток для всех входных точек выборки. Кластеры нумеруются с0, 1, 2..., а выбросы строго обозначаются как-1. - Очистка выборки от выбросов: для удаления шума из датасета достаточно отфильтровать строки:
X_clean = X[db.labels_ != -1]. - Критичность масштабирования: параметр
epsизмеряется в единицах признакового пространства. Если признаки имеют разный масштаб (например, возраст от 18 до 80 и зарплата от 30 000 до 300 000), радиусeps=0.5приведет к деградации алгоритма. Поэтому перед запуском DBSCAN обязательно применятьStandardScaler.
План занятия
-
Концепция плотностной кластеризации
- Ограничения методов на основе центроидов (K-Means).
- Определение кластера как связной области высокой плотности данных.
- Сравнение подходов: разбиение пространства vs трассировка связности.
-
Математический аппарат алгоритма DBSCAN
- Гиперпараметры: радиус окрестности \(\varepsilon\) (
eps) и порог плотностиmin_samples. - Классификация точек: Core (ядро), Border (граница), Noise (шум).
- Условия плотностной достижимости и прямого включения в кластер.
- Рекурсивный алгоритм расширения границ кластера.
- Гиперпараметры: радиус окрестности \(\varepsilon\) (
-
Ключевые преимущества и сценарии применения
- Автоматическое определение количества кластеров без задания \(k\).
- Обнаружение кластеров произвольной формы (make_moons, концентрические кольца).
- Использование DBSCAN в задачах обнаружения аномалий (банковский антифрод).
- Очистка обучающих выборок от статистического шума (метка
-1).
-
Практика в Scikit-Learn и тонкости настройки
- Класс
sklearn.cluster.DBSCANи извлечение метокlabels_. - Обязательность масштабирования признаков с помощью
StandardScaler. - Анализ поведения модели при варьировании
epsиmin_samples. - Визуализация нелинейных кластеров на плоскости.
- Класс