
Урок 16. Кластеризация данных: метод k-средних (KMeans), k-means++ и подбор кластеров
На этом занятии мы открываем принципиально новый раздел машинного обучения — обучение без учителя (Unsupervised Learning). До сих пор в задачах регрессии и классификации мы всегда имели размеченную обучающую выборку с известным вектором ответов \(y\). Но как извлекать скрытые закономерности, если разметки нет, а ручной труд экспертов невозможен или слишком дорог? Мы подробно изучим базовую задачу этого направления — кластеризацию данных, разберем по шагам популярный метод k-средних (K-Means), поймем логику перемещения центроидов, разберемся в инициализации k-means++ и научимся объективно подбирать оптимальное число кластеров с помощью метода локтя (Elbow Method).
1. Обучение без учителя: суть и прикладные задачи кластеризации
Кластеризация (кластерный анализ) — это задача автоматического разделения множества неразмеченных объектов на группы (кластеры) на основе их признакового описания.
Фундаментальный математический принцип кластеризации строится на двух правилах:
- Высокая внутрикластерная схожесть: объекты, попавшие в один кластер, должны быть максимально близки друг к другу по своим признакам.
- Высокая межкластерная различимость: объекты из разных кластеров должны быть максимально удалены и изолированы друг от друга.
Мысленный эксперимент (Кластеризация как шаг к классификации): Представьте, что вы ботаник Эдгар Андерсон, собравший 150 цветков ириса и измеривший их параметры, но никаких классов еще не существует. Вместо субъективного деления «на глаз» специалист по анализу данных запускает кластеризацию по 4 признакам. Алгоритм делит данные на 3 плотные группы. После этого достаточно взять всего по одному типовому цветку из каждой группы, определить их биологический вид у эксперта и мгновенно присвоить осмысленные метки (Setosa, Versicolor, Virginica) всем сотням объектов сразу.
Основные сферы применения кластеризации в бизнесе и Data Science:
- Маркетинг: клиентская сегментация по покупательской способности, среднему чеку и частоте визитов для персонализированных акций.
- Анализ текстов (NLP): автоматическая группировка сотен тысяч новостных статей или обращений техподдержки по темам.
- Социальные графы: выявление устойчивых сообществ и групп по интересам.
- Обнаружение аномалий (Anomaly Detection): объекты, которые в силу своей нестандартности не примкнули ни к одному из сформированных плотных кластеров, трактуются как аномалии, выбросы или случаи мошенничества.
В библиотеке scikit-learn реализовано множество алгоритмов кластеризации, но фундаментальными считаются два противоположных подхода: K-Means (основан на центроидах и сферических расстояниях) и DBSCAN (основан на плотности точек в пространстве). На этом уроке мы фокусируемся на K-Means.
2. Принцип работы алгоритма K-Means (Метод k-средних)
Главная особенность метода K-Means заключается в том, что количество кластеров \(k\) должно быть строго задано до запуска алгоритма.
Каждый кластер описывается своим центром масс — центроидом. Обучение модели заключается в итеративном поиске таких координат центроидов, при которых суммарное квадратичное отклонение объектов от центров своих кластеров будет минимальным.
Пошаговый алгоритм:
- Инициализация: Алгоритм случайным образом выбирает \(k\) точек обучающей выборки и назначает их начальными центроидами:
$$ C = \{c_1, c_2, \dots, c_k\} $$ - Шаг привязки (Assignment Step): Для каждого объекта выборки \(x_i\) вычисляется евклидово расстояние до всех \(k\) центроидов. Объект приписывается к тому кластеру, чей центроид оказался к нему ближе всего:
$$ S_j = \{ x_i : \|x_i – c_j\|^2 \le \|x_i – c_l\|^2 \quad \forall l, 1 \le l \le k \} $$ - Шаг пересчета (Update Step): Для каждого полученного кластера вычисляются новые координаты центроида как среднее арифметическое векторов всех точек, вошедших в этот кластер:
$$ c_j = \frac{1}{|S_j|} \sum_{x_i \in S_j} x_i $$ - Критерий сходимости: Шаги 2 и 3 циклически повторяются до тех пор, пока центроиды не перестанут менять свое положение (или пока смещение не станет меньше заданного порога толерантности), либо пока не исчерпается лимит итераций
max_iter.
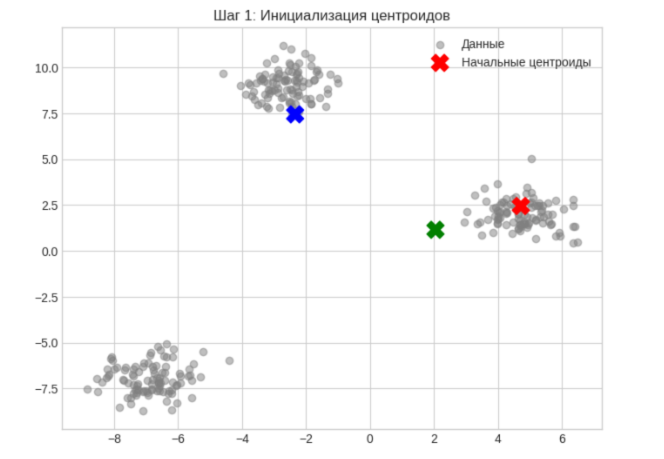
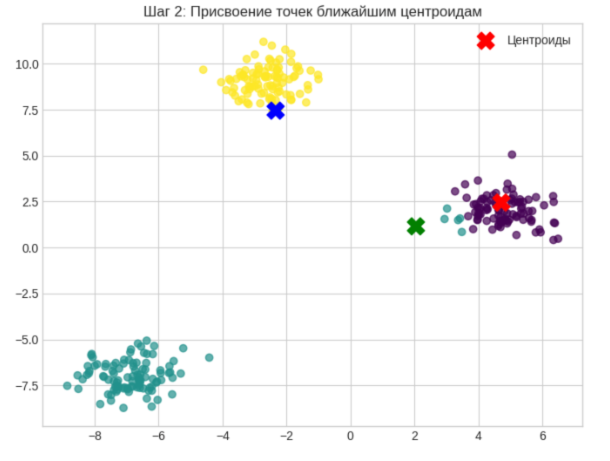
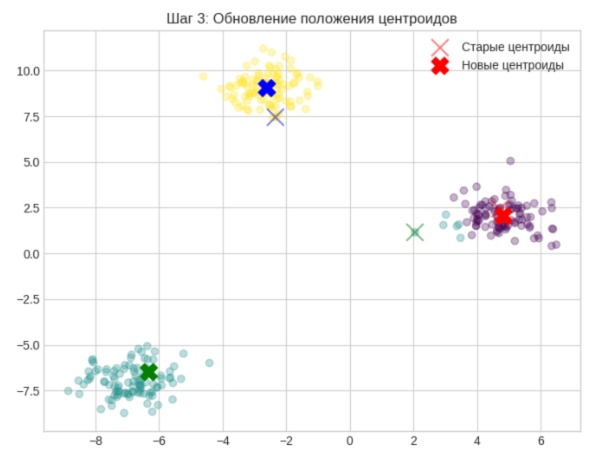
Геометрические допущения K-Means: Алгоритм делит пространство строго сферическими (гиперсферическими) границами одинакового размера (диаграммы Вороного). Если реальные кластеры имеют вытянутую форму, сложную топологию (полумесяцы, кольца) или разную плотность, K-Means разделит их некорректно. Кроме того, K-Means крайне чувствителен к выбросам, так как расчет среднего арифметического сильно смещает центроид в сторону экстремальной точки.
3. Проблема случайного старта и умная инициализация (k-means++)
Поскольку стартовые центроиды выбираются случайно, неудачный выбор может затянуть оптимизацию или привести алгоритм в субоптимальный локальный минимум. Scikit-Learn решает эту проблему двумя механизмами:
1. Многократный перезапуск (параметр n_init)
По умолчанию модель обучается n_init=10 раз с разных случайных стартовых позиций. Из 10 полученных вариантов выбирается разбиение с наименьшей итоговой ошибкой (инерцией). На гигантских массивах данных значение n_init иногда уменьшают ради ускорения вычислений.
2. Алгоритм инициализации ‘k-means++’
Вместо полностью случайного выбора Scikit-Learn по умолчанию использует стратегию init='k-means++':
- Первый центроид выбирается случайно из обучающих объектов.
- Каждый следующий центроид выбирается из оставшихся точек с вероятностью, пропорциональной квадрату расстояния до уже выбранных центроидов:
$$ P(x) = \frac{D(x)^2}{\sum D(x’)^2} $$
Такой подход заставляет центроиды гарантированно стартовать в максимально удаленных друг от друга областях признакового пространства, что резко повышает скорость сходимости и устойчивость разбиения.
4. Практическая реализация K-Means в Scikit-Learn
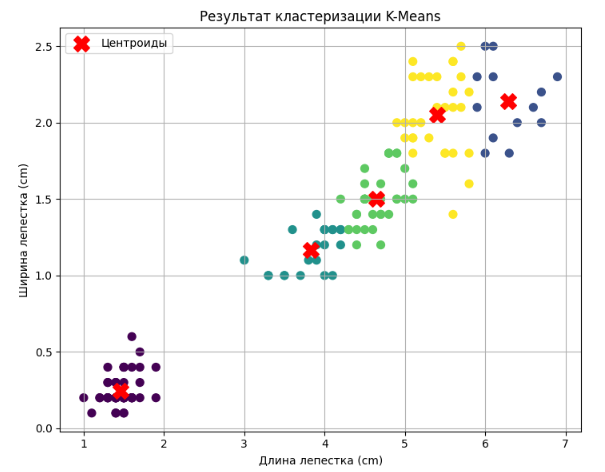
Проведем кластеризацию датасета Ирисов Фишера по двум признакам (длине и ширине лепестка), принципиально не передавая модели метки классов \(y\):
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.cluster import KMeans

# 1. Загрузка данных (берем только матрицу признаков X)
iris = load_iris()
X = iris.data[:, 2:] # Длина и ширина лепестка (petal length, petal width)

# 2. Инициализация и обучение K-Means на 3 кластера
kmeans = KMeans(n_clusters=3, init='k-means++', n_init=10, random_state=42)
kmeans.fit(X)

# 3. Получение меток кластеров для обучающих точек
labels = kmeans.labels_

# 4. Координаты найденных центроидов
centroids = kmeans.cluster_centers_
print("Координаты центроидов:\n", centroids)

# 5. Визуализация кластеров и их центров
plt.figure(figsize=(10, 6))
plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='viridis', s=50, alpha=0.8, label='Объекты кластеров')
plt.scatter(centroids[:, 0], centroids[:, 1], c='red', marker='X', s=200, label='Центроиды')
plt.title('Кластеризация Ирисов с помощью K-Means (k=3)')
plt.xlabel('Длина лепестка (см)')
plt.ylabel('Ширина лепестка (см)')
plt.legend()
plt.grid(True)
plt.show()

# 6. Предсказание кластера для нового объекта
new_flower = [[5.0, 1.8]]
predicted_cluster = kmeans.predict(new_flower)
print(f"Новый цветок отнесен к кластеру: {predicted_cluster[0]}")
Обученная модель хранит в оперативной памяти исключительно координаты центроидов (атрибут cluster_centers_). При вызове метода predict() для нового объекта алгоритм просто находит ближайший к нему центроид.
5. Подбор оптимального числа кластеров: Метод локтя (Elbow Method)
В большинстве прикладных задач количество кластеров \(k\) заранее неизвестно. Если выбрать слишком мало кластеров — данные объединятся в разнородную кашу; если слишком много — кластеры распадутся на бессмысленные мелкие осколки (при \(k = N\) каждая точка станет своим кластером с нулевой ошибкой).
Что такое инерция (Inertia / WCSS)?
Для оценки компактности кластеров используется метрика инерции (Within-Cluster Sum of Squares, WCSS) — сумма квадратов расстояний от каждой точки до центроида своего кластера:
$$ \text{Inertia} = \sum_{j=1}^{k} \sum_{x_i \in S_j} \|x_i – c_j\|^2 $$
В Scikit-Learn значение инерции доступно через атрибут kmeans.inertia_.
Суть метода локтя:
- Обучаем модель K-Means последовательно для диапазона значений \(k\) (например, от \(1\) до \(10\)).
- Для каждого \(k\) фиксируем значение итоговой инерции.
- Строим двумерный график: по оси \(X\) — число кластеров \(k\), по оси \(Y\) — инерция.
- При увеличении \(k\) инерция монотонно падает. Однако на графике формируется характерный излом (перегиб, напоминающий согнутый локоть руки). До точки перегиба добавление новых центроидов кардинально снижает ошибку, а после неё — дает лишь минимальный прирост. Точка этого излома и принимается за математически обоснованное число кластеров.
# Расчет инерции для k от 1 до 10
inertias = []
k_range = range(1, 11)

for k in k_range:
    model = KMeans(n_clusters=k, init='k-means++', n_init=10, random_state=42)
    model.fit(X)
    inertias.append(model.inertia_)

# Построение графика метода локтя
plt.figure(figsize=(10, 6))
plt.plot(k_range, inertias, 'bo-', linewidth=2, markersize=8)
plt.title('Подбор оптимального k методом локтя (Elbow Method)')
plt.xlabel('Количество кластеров (k)')
plt.ylabel('Инерция (Inertia / WCSS)')
plt.xticks(k_range)
plt.grid(True)
plt.show()
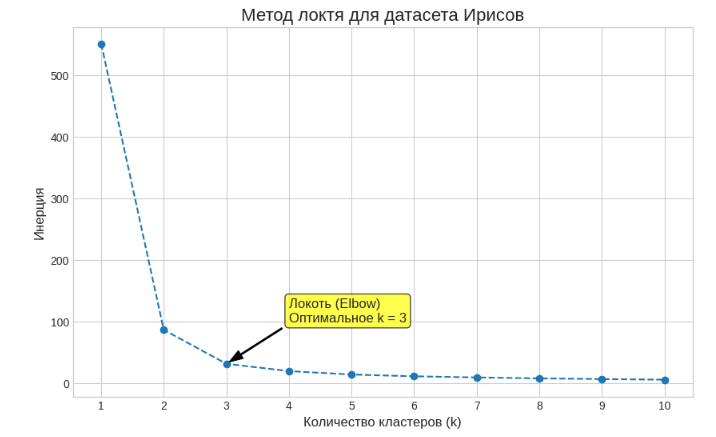
На датасете Ирисов график демонстрирует отчетливый изгиб в районе \(k = 2\) и \(k = 3\), подтверждая объективное разделение выборки на плотные группы без использования внешних подсказок учителя.
План занятия
-
Введение в обучение без учителя (Unsupervised Learning)
- Проблема отсутствия разметки данных в реальных задачах.
- Формализация задачи кластеризации: внутрикластерная компактность и межкластерная изоляция.
- Бизнес-кейсы: клиентская сегментация, группировка текстов и картинок, детекция аномалий.
- Обзор методов кластеризации в библиотеке Scikit-Learn: K-Means vs DBSCAN.
-
Математические основы и механика K-Means
- Понятие центроида как центра масс группы объектов.
- Трехшаговый итерационный цикл: инициализация центров, привязка по евклидову расстоянию, пересчет средних координат.
- Критерии сходимости и остановки алгоритма.
- Геометрические ограничения модели: сферичность кластеров и чувствительность к выбросам.
-
Преодоление проблемы начальной инициализации
- Зависимость сходимости от случайного начального выбора центроидов.
- Параметр
n_init: серия независимых перезапусков с отбором лучшего решения. - Алгоритм
k-means++: вероятностное разнесение стартовых центроидов в пространстве.
-
Практика кластеризации в Scikit-Learn
- Применение класса
sklearn.cluster.KMeansна датасете Iris без целевых меток. - Извлечение координат центроидов через атрибут
cluster_centers_. - Привязка новых объектов к сформированным кластерам методом
predict(). - Визуализация результатов разбиения и сопоставление со скрытыми природными классами.
- Применение класса
-
Определение числа кластеров методом локтя (Elbow Method)
- Понятие инерции кластера (WCSS / Inertia) и формула квадратичного отклонения.
- Циклический расчет инерции для диапазона значений \(k\) от 1 до 10.
- Построение и визуальный анализ графика функции инерции.
- Поиск точки перегиба («локтя») для выбора оптимального гиперпараметра
n_clusters.